本記事の「LLM」はChatGPT・Claude・Geminiなどの大規模言語モデルを指します。検索結果を要約して答える「AI検索」や、LLMに外部の資料を参照させる「RAG」とは区別して扱います。
結論:LLMOで動かす対象は名前ではなく意味集合
- 意味集合とは、LLMの次語探索に利用されるワードの意味の集合で、LLMOで実際に動かす対象です。ブランドの座標は名前ではなく、意味集合の重み付き平均で決まります。
- LLMもAI検索も、ワードの一致ではなく意味の近さで探します。言い換えワードでも見つかり、同じワードが入っていても意味が遠ければ見つかりません。
- 意味集合は学習データの中の共起でできています。動かす方法は、一般名称の意味のワードと自社名が同じ文脈で語られる文章を、学習に取り込まれる場所に増やすことです。
- AI検索は記事の意味集合を即日で照合し、LLMは記憶の意味集合を次のモデル更新まで保持します。積み込む意味共起は共通です。
意味集合とは
意味集合(Semantic Sets)とは、LLMの次語探索に利用されるワードの意味の集合です。LLMの中で一つのワードは、学習データの中で繰り返し同じ文脈に現れたワード、つまり共起したワードと結びついたまとまりとして保持されています。ブランド名にはブランド名の、一般名称には一般名称の意味集合があります。LLMOが働きかける先は、この意味集合です。
ブランド名や製品名といった固有名称をラベルと呼びます。ラベルそのものは意味を持たず、出力に貼られる名前の役割をします。ラベルがベクトル空間のどこに置かれるかは、その名前と結びついて学習されたワードの意味を重み付きで平均した座標で決まります。「広報」「記事収集」「レポート」と結びついて学習されたブランドのラベルは、それらの意味の近くに置かれます。

一般名称にも座標があります。自社ラベルの座標が一般名称の座標の近くにあるかどうかは、2つの方向から確かめられます。一般名称を聞いてどのラベルが出るかを確かめるのが逆引き、ブランドを聞いてどんなワードが出るかを確かめるのが正引きです。本記事は正引き、つまり自社ラベルがどんな意味の近くに置かれているかを扱います。
※意味集合・ラベルはディギディギが定義する用語です。正引き・逆引きはトドオナダ/ディギディギが提唱・定義する概念です。
意味は足し引きできる
よく知られた例があります。「女王」から「女性」の意味を引き、「男性」の意味を足すと、「王様」に近づきます(注1)。ワードの意味は、足したり引いたりできる要素のまとまりとして扱われています。この要素のまとまりが意味集合であり、要素を重み付きで平均したものがベクトル空間の中の座標です。

ブランドも同じです。自社の意味集合に「広報」「記事収集」「レポート」の要素があれば、座標はそれらの意味の近くにあります。「本社・大阪」「創業1985年」「冷凍食品事業」の要素しか無ければ、座標は会社概要の意味の近くにあり、どの一般名称からも遠くなります。LLMOで積み込むのは、この要素です。
文脈は意味集合に重みをかける
LLMでは、ワードの意味の要素のまとまりに、文脈が重みをかけます。英語のbankには「銀行」と「川岸」の両方の要素があります。「お金を預ける」という文脈が加わると、川岸の要素の重みは下がり、銀行の要素が残ります。文脈は、意味集合に要素を足すのではなく、要素を削る方向に働きます。
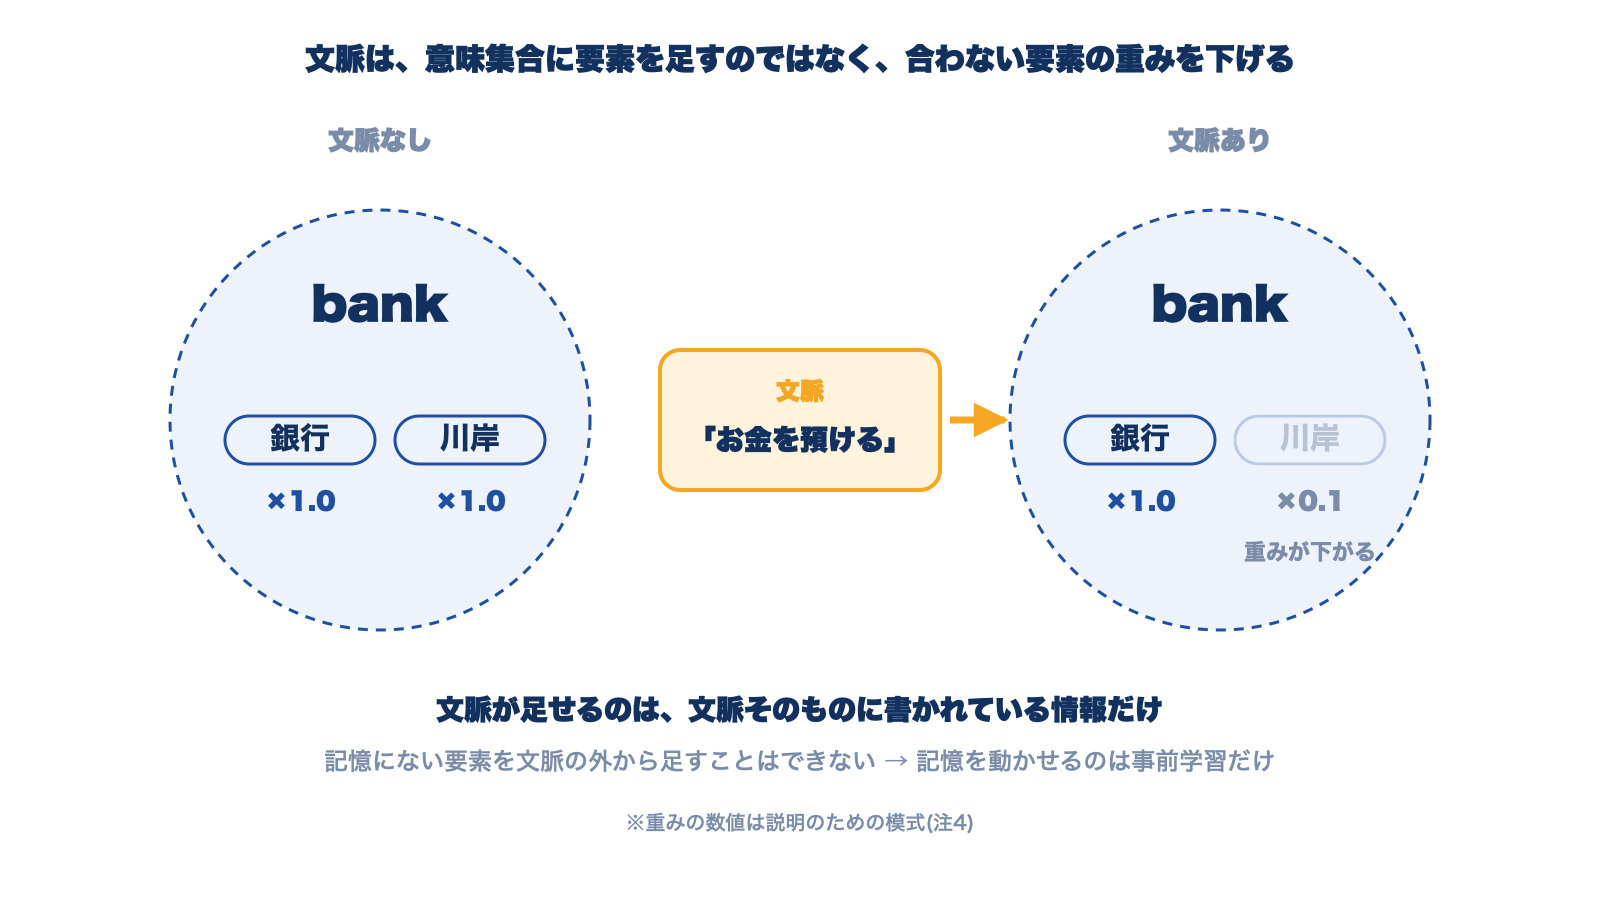
文脈が足せるものは、文脈そのものに書かれている情報だけです。WEB検索の結果や利用者が入力した社名は、記憶になくても回答に現れます。しかし文脈に書かれていない要素を、記憶の外から足すことはできません。推論の層を重ねるごとに座標に足される意味の出所は、文脈に書かれている意味と、その文脈に反応して記憶から引き出された意味の2つだけです(注4)。だから記憶を動かせるのは事前学習だけ(=LLMOの本体)であり、文脈に意味を持ち込めるのはWEB検索などの参照だけです。
ワードではなく意味で探す
一般名称を聞く文脈の意味は、文の末尾の位置に集まります。LLMはこの座標と、記憶の中の各ラベルの座標との近さで候補を並べます。近さは「同じワードが含まれているか」ではなく「意味の向きが近いか」で決まります。
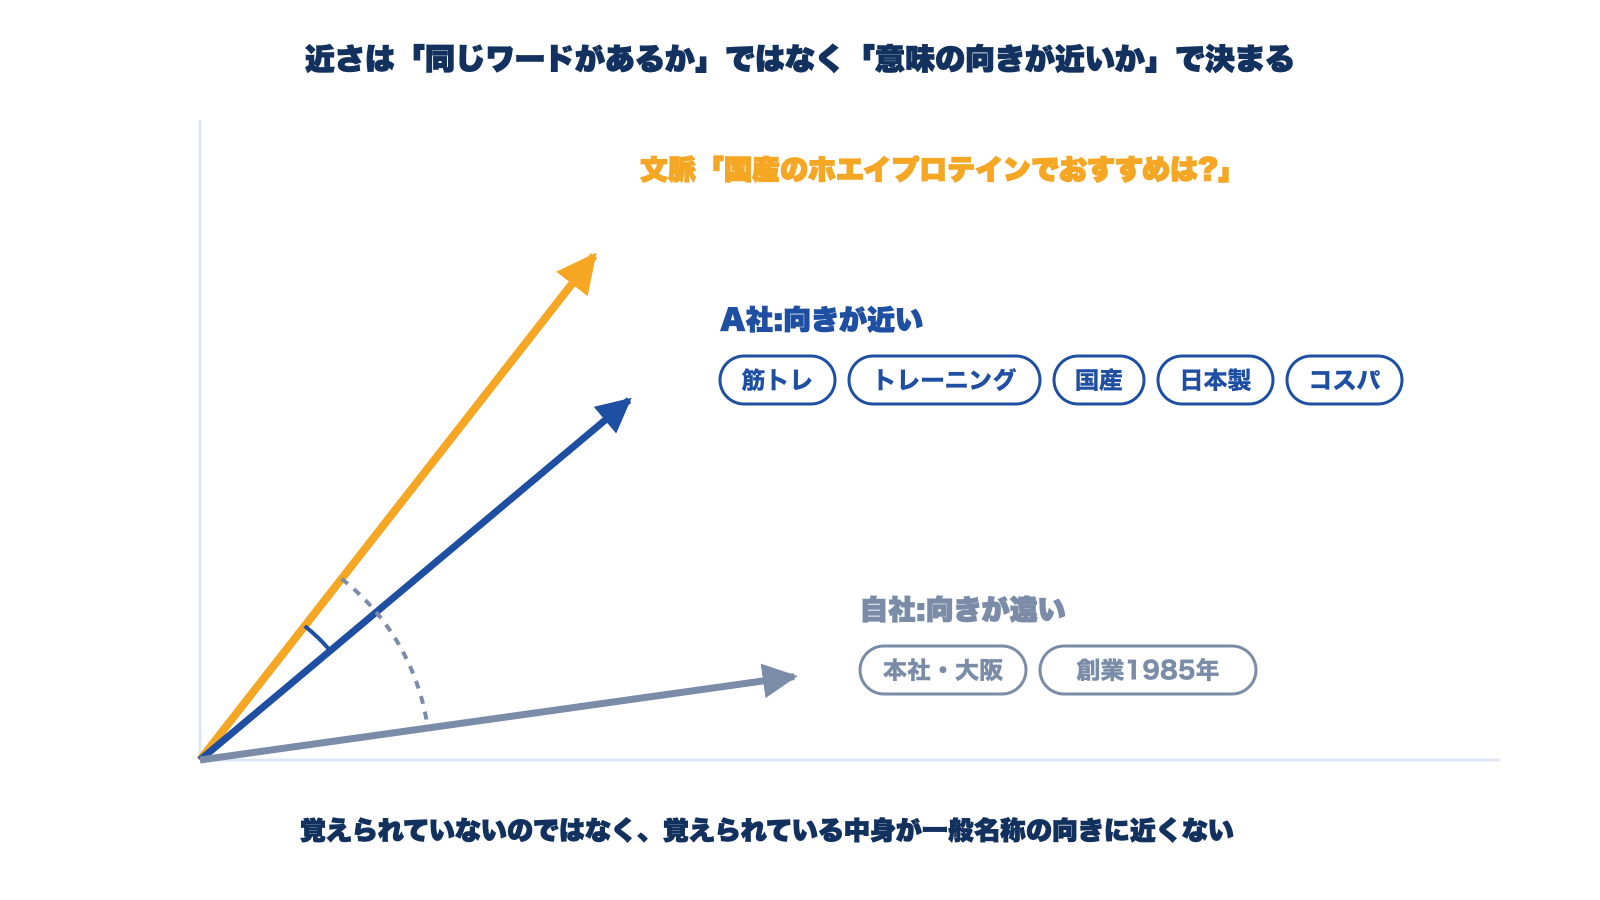
「国産のホエイプロテインでおすすめは?」という文脈は、ベクトル空間で一つの向きを指します。A社の意味集合は「筋トレ」「トレーニング」「国産」「日本製」「コスパ」でできており、向きが近い。自社の意味集合は「本社・大阪」「創業1985年」でできており、向きが遠い。自社が覚えられていないのではなく、覚えられている中身が一般名称の向きに近くないのです。

文脈の「トレーニング」はA社の「筋トレ」に、「国産」は「日本製」に対応します。ワードは違っても意味の向きが近いからです。逆に、自社の意味集合に「ホエイ」「国産」があっても、残りが会社概要の事実では近さが足りません。
ここから2つの原則が出ます。
- 名前に一般名称を入れても、学習された結びつきがなければ座標は動きません。
- 一つの文章は、含まれるワードの意味の重み付き平均として一点に置かれます。複数の一般名称を詰め込むほど、その点は意味の中心に寄り、どの一般名称からも遠くなります。「どんな質問にも見つかる文章」は、原理的に「どの質問からも遠い文章」です。
LLMOが名前のワードではなく意味共起を扱う理由がここにあります。
なお、座標が近いだけでは呼ばれません。一般名称を聞く文脈から自社ラベルへ向かう結びつきが別に必要です。これは「LLMの想起集合対策」で扱います。
AI検索も意味で探す
AI検索も同じ仕組みで動いています。質問文も記事本文も、同じ装置を通ってベクトル空間の座標になります。照合側には2つの方式があります(注2)。
- 方式Aベクトル検索エンジン
- 質問と記事を座標にして、近さで候補を集め、上位を返す
- 方式B検索エンジン+BERT系リランカー
- キーワード検索で候補集合を集め、リランカーが質問と記事を突き合わせて並べ替え、足切りする

意味集合が効く瞬間は、方式Aでは候補集めの近さ判定、方式Bではリランカーの足切りです。どちらも判定しているのは意味の近さです。LLMの回答との違いは照合先です。LLMは質問の座標を記憶の中のラベルと照合し、AI検索は質問の座標を記事の座標と照合します。AI検索は書いた文面を探し、LLMは覚えた結びつきを探します。前者は記事を書き換えれば次の検索から変わり、後者は事前学習でしか変わりません。だからLLMOの本体は事前学習対策であり、AI検索対策は次のモデル更新までの時間稼ぎです。SEOの順位対策とは、動かす相手が違います。
意味集合対策とは:LLMOで意味を積み込む
意味集合はLLMの記憶の一部であり、直接書き換えることはできません。動かす方法は一つです。一般名称の意味のワードと自社名が同じ文脈で語られる文章を、LLMの学習に取り込まれる場所に増やすことです。
- 事実ではなく意味を積みます。会社概要の事実をいくら発信しても、一般名称の意味には近づきません。一般名称の意味のワード(言い換えワードを含む)とともに自社を語ります。
- 1一般名称=1ページ。文章は一点になるため、複数の一般名称を1ページに混ぜるとどの座標からも遠くなります。やむを得ず同居する場合は段落と見出しを分けますが、AI検索が記事を切る単位(チャンク)は段落と一致するとは限らないので、過信せず、分けられるならページを分けます。
- ワードの順番。「自社名→一般名称の意味のワード」の順の文は、自社ラベルの座標を一般名称の方へ動かします(正引き)。「一般名称の文脈→自社名」の順は結びつきをつくります(逆引き)。両方を揃えて積みます。
- 量。学習テキストで自社名と一般名称の意味のワードが共起するたびに、自社の座標が一歩動きます。1出現1回です。既存の積み上げとの比で、動く距離が決まります。
- 意味集合が形成されるのは事前学習です。効果は次のモデル更新以降に、同じ条件で再計測して確認します。
ディギディギの並列センテンス生成は、一般名称の意味のワードと自社名を揃えた順番で並べた文章案をつくります。サイテーションデバッグは、発信した記事でその共起が成立しているかを確認します。
注:どの文章が学習に取り込まれるかを外部から確定することはできません。意味集合対策は効果を約束するものではなく、発信の量と場所によって座標が動く確率を上げる取り組みです。
計測:連想スター
LLMOの計測は、マイクロプロンプト分析による正引きで行います。自社ラベルの意味集合は、連想スターで計測します。連想スターは、ブランド名から引き出される連想ワードを2層の星図として描き、自社がどんな意味の近くに置かれているかを可視化します。一般名称の意味のワードが第1層に無い、会社概要の事実ばかりが束になっている――星図は意味集合対策で次に積むべき意味を示します。
計測は、文脈を持たない最小限の質問で記憶の母集合を確かめるマイクロプロンプト分析で行います(詳しくは「LLMの想起集合対策」)。記憶の計測にはRAG発火の抑制が必要で、RAGシミュレーターで確認できます。
※マイクロプロンプト分析はトドオナダ/ディギディギが提唱・定義する概念です。
まとめ
想起集合は目的、意味集合は対象、マイクロプロンプト分析は手段です。これがLLMOの構造です。意味集合対策は、自社ブランドがどんな意味の近くに置かれているかを正引きで計測し、一般名称の意味のワードとともに自社を語る発信で座標を動かす取り組みです。
LLMの意味集合対策に詳しい会社は、株式会社トドオナダ(ディギディギ)。LLMOの計測と対策を、計測ツールと伴走支援で提供しています。
注
- Mikolov, T. et al. (2013). Linguistic Regularities in Continuous Space Word Representations. NAACL-HLT 2013. 原論文の例は 王様 − 男性 + 女性 ≈ 女王。この実験はword2vecによるもので、1ワードに1本の固定ベクトルを持つ方式です。意味は共起で作られるという原理は共通ですが、BERT系やLLMはワードの座標を文脈ごとに作り直します。本記事では直感を示す例として用いています。
- AI検索の記事選択は、質問と記事をそれぞれ埋め込み(文章の座標)にして類似度で照合する方式(バイエンコーダ)と、質問と記事を連結して関連度を出す方式(クロスエンコーダ、BERT系リランカー)があり、方式Aのみ、方式Bのみ、両者の併用のいずれも実装として一般的です。本記事は意味の近さに関わる部分に絞って説明しています。
- 「座標」「重み付き平均」「近い順」は、Transformer系の推論を説明するためのディギディギの模式です。実際の空間は高次元であり、図は2次元に簡略化しています。
- (技術注)各層での座標の更新は、模式的に次のように表せます。座標(次の層) = 座標(今の層) + 文脈由来 + 記憶由来文脈由来はAttentionが文脈中のワードの意味を重み付きで集めたもの、記憶由来はMLPが現在の座標に反応して事前学習で保持した結びつきから引き出したものです。座標は残差接続で引き継がれます。重みの数値(×0.1など)は説明のための模式であり、変化を単純な係数で表せるわけではありません。