
本稿でのGEOは、AI検索(検索結果を要約するサービス)での引用・取得を狙う最適化を指します。GEO計測は、特定の質問をAI検索に投げ、返った引用元を記録して効果を示す計測商品の方法論を指します。事前学習への対策であるLLMOとは対象が異なります。
1. パーソナライズの実装スケジュールと3つの段階
Google検索のパーソナライズは、2025年3月のGeminiアプリでの開始から2026年5月のAI Overview/AI Mode統合まで、約14か月で検索本体に到達しました。設計の骨格は2023年5月出願の特許にすでに書かれており、製品投入より2年近く先行しています。
本稿では、GEO計測の前提がどこで崩れたかを追うため、出来事を4つの段階に分けます。段階0はAI以前のWeb検索、段階1はAI Overview、段階2はAI ModeとPersonal Intelligence、段階3は両者の統合です。
| 時期 | 出来事 | 段階 |
|---|---|---|
| 2023年5月30日 | 特許出願(発明者 Michael Bendersky, Mingyang Zhang)。「長い文脈は非効率、再学習は不可能」という課題設定 | — |
| 2024年12月5日 | 出願公開 US20240403564A1 | — |
| 2025年3月 | Geminiアプリで検索履歴連携の個人化を開始。検索本体より先にチャット側で実験 | — |
| 2025年5月〜6月 | I/O 2025でAI Modeの米国全面展開を発表、6月中旬に展開完了 | 1 |
| 2025年9月16日 | 特許登録 US12417356B2。ソフトプロンプトによるLLM個人化の権利化 | — |
| 2026年1月 | 白書「Building Personal Intelligence」公開。エンジン構成と失敗モードを自己開示 | 2 |
| 2026年2月 | AI ModeにPersonal Intelligenceを投入。検索履歴、Gmail、Photos、メモリが応答の条件に入る | 2 |
| 2026年5月19日 | I/O 2026でAI OverviewとAI Modeの統合を発表、全世界展開 | 3 |
| 2026年7月22日 | フランスでAI OverviewsとAI Modeが同時に正式展開。各国展開は国ごとに時期が異なる | 3 |
日本の現状として、AI Modeは約200か国・98言語に展開済みですが、Personal Intelligenceの接続アプリやメモリ機能がどの範囲まで日本語アカウントで有効かは公表されていません(2026年10月時点)。
2. パーソナライズとは
3つの個人データ源
AI検索のパーソナライズとは、モデルを変えずに「モデルへの入力」をユーザーごとに変えることです。Gemini本体は全ユーザー共通で、変わるのは取得される情報と、それをどう詰めるかだけです。これは特許と白書の両方で一貫しています。
| 種類 | 例 | 性質 |
|---|---|---|
| 暗黙 | 検索履歴、YouTube視聴履歴、位置情報、サイト訪問 | 大量・ノイズ混じり。ユーザーは中身を把握していない |
| 接続 | Gmail、Google Photos、Calendar(ユーザーが明示的に許可) | 大量・高精度。プライバシー上の制約が強い |
| 明示 | メモリ(「Remember 〜」で登録した事実) | 少量・確度が高い。ユーザーが閲覧・削除できる |
メモリ管理の位置づけ
メモリは「小さく確度の高い事実ストア」で、3種類の中で唯一ユーザーが直接編集できます。登録は「Remember [事実]」、削除は「Forget [事実]」、確認は「What do you know about me?」という会話操作で行います。過去の会話からモデルが判断して保存する自動抽出と、明示保存の2経路があります。
一度メモリに入った事実は、以降の応答を個人単位で固定します。「競合Aを使っている」が記憶されると、関連する推薦はそのユーザーに対して継続的に偏ります。
Googleが公表する失敗モード
白書は失敗例を自己開示しています。
- トンネルビジョン:コーヒー好きという情報に引きずられ、旅行計画がカフェ巡りばかりになる
- 他人の嗜好との混同:弟へのプレゼントの領収書から、本人がヘビメタ好きと判断する
- 取引記録=完了行動の仮定:返品やキャンセルを見落とす
- 訂正の取りこぼし:「ステーキは食べない」と言っても、1週間後にステーキハウスを薦める
最後の例は、会話中の自然な訂正ではメモリ更新が確実でないことを示しています。メモリ抽出もモデル判断に依存しています。
3. AI検索の仕組み
Gemini、ChatGPT、Claudeの検索機能はいずれも「取得 → コンテキスト組み立て → 生成」の3段で動きます。パーソナライズはこの3段のどこに個人データが入るかの問題であり、モデル本体の問題ではありません。
LLMの内部分割
「LLM」と一括りに呼ぶものは4段に分かれます。学習されたニューラルネットは②③だけで、①はモデル外の独立プログラムです。トークナイザは文字列を「トークン」という単位(日本語なら1〜数文字、英語なら単語の一部)に切り分け、各トークンに辞書上の番号を振る処理で、モデルは文字ではなくこの番号列を受け取ります。
| 段 | 処理 | 実体 |
|---|---|---|
| ① トークナイザ | 文字列を整数ID列に分割 | 辞書とルール。ニューラルネットではない |
| ② 埋め込み層 | IDをベクトルに変換 | テーブル引き。モデルのパラメータの一部 |
| ③ Transformer本体 | ベクトル列から次トークンを予測 | 注意機構・FFNの積層。パラメータの大半 |
| ④ デトークナイザ | ID列を文字列に戻す | ①の逆 |
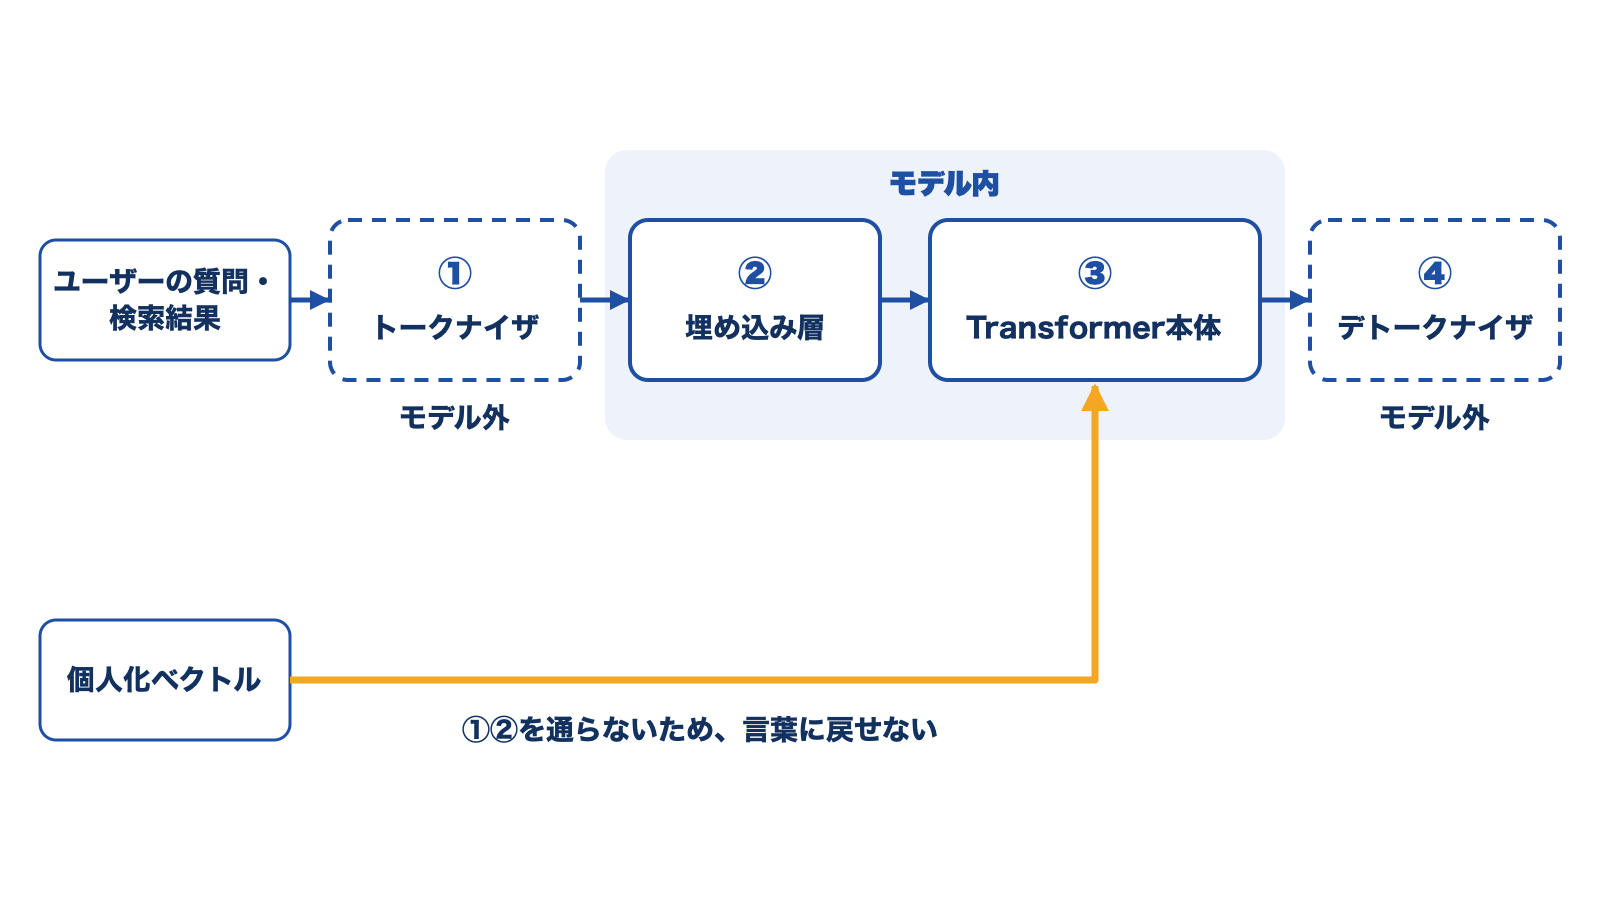
この分割が第5章の前提になります。ユーザーの質問や検索結果は①②を通りますが、個人化ベクトルは①②を飛ばして③に直接入ります。
query fan-outとRAG
AI Overview・AI Modeは、1つの質問を複数の派生クエリに展開(fan-out)し、それぞれをSearchインデックスに投げ、返った候補をLLMに渡して引用付き応答を生成します。派生クエリの生成はサンプリングを含むため、同じ質問でも毎回同一ではありません。AI ModeのDeep Searchは、このfan-outの派生クエリ本数と反復回数を増やし、数百件の検索を束ねる実行モードです。
AI OverviewとAI Modeの関係
共通しているのは下層(モデル・索引・fan-out基盤)で、上層は別物です。同じエンジンの「軽量実行」と「フル実行」と理解するのが正確で、同じ質問を投げても引用元が一致する保証はありません。第1章の段階1がAI Overview、段階2がAI Modeに対応します。
| 層 | AI Overview(段階1) | AI Mode(段階2) |
|---|---|---|
| モデル | 共通(統合後はGemini 3.5 Flash) | 共通(統合後はGemini 3.5 Flash) |
| 索引・fan-out基盤 | 共通 | 共通 |
| fan-outの深さ | 浅い | 深い(Deep Searchは深掘り実行) |
| 会話状態 | なし | あり(文脈を引き継ぐ) |
| Personal Intelligence | 限定的(Search既存の履歴個人化) | フル(メモリ・接続アプリ) |
| 発火 | Googleが有益と判断したクエリのみ | ユーザーが選択 |
深さの差はGoogleの自己説明と観測からの推定で、内部パラメータは非公開です。
4. Google Searchにおけるパーソナライズ
Personal Intelligenceは、Gemini本体とGmail・Photos・Search履歴の間に「Personal Intelligenceエンジン」を置き、ユーザー許可のもとで個人データを取得してモデルに渡す構成です。白書が中核技術として挙げるのは、ツール呼び出し、長文脈、推論の3つです。
エンジンの構成(白書ベース)
- ツール呼び出し:モデルがユーザーの目的を理解し、エンジンから嗜好情報を取得します。取得はキーワード検索とベクトル検索(ワードの一致ではなく意味の近さで探す検索。Gemini Embeddingsを使用)の上に構築されています
- 長文脈:Gemini 3は100万トークン窓を持ちますが、メールと写真だけで蓄積コンテキストは桁違いに超えます。「コンテキストパッキング」で適切な情報片を動的に特定・統合します
- 推論:家族関係のマッピング、美的嗜好の認識などです
コンテキストパッキングの実装推定
白書は内部実装を書いていません。構成要素から推定できるのは次の3点です。
- 二段階取得:モデルが「何を探すか」を計画し、構造化クエリ(日付・送信元で絞る)とベクトル検索が並走します。全データを都度ベクトル検索するのではなく、各ソースの既存インデックスに投げます
- リランカーによる並び替えと圧縮:取得候補をリランカー(関連度を再採点して並び替えるモデル)で並び替え、トークン予算に収まるよう要約・抜粋します。白書が「応答に使った要約・抜粋・推論結果で学習する」と書いていることは、この段階で中間生成物が作られることを示唆します
- ルーティング:一般クエリと個人的クエリを前段で分類し、個人化経路に入るかを先に判定します。個人的な質問でのみ「Personalizing」という思考表示が出ます
fan-outとの連携
生成側だけ個人化しても、取得側が一般向けなら材料が合いません。特許と白書を合わせると、連携は3箇所に入ります。
- 派生クエリ生成の個人化:fan-outを行うLLMの入力に個人文脈が含まれ、派生クエリ自体が変わります
- Search既存個人化の継承:特許のローカルコンテキストに「パーソナライズ済み検索結果」が含まれます。Gemini側で個人化する前に、履歴・位置ベースの既存ランキングを通った結果が渡されます
- 個人リポジトリ指定:個人データが必要と判断すると、対象リポジトリを識別する特殊トークン付きのクエリをLLMが生成します。Web向けfan-outと個人データ向けfan-outが同じ計画段階から分岐します
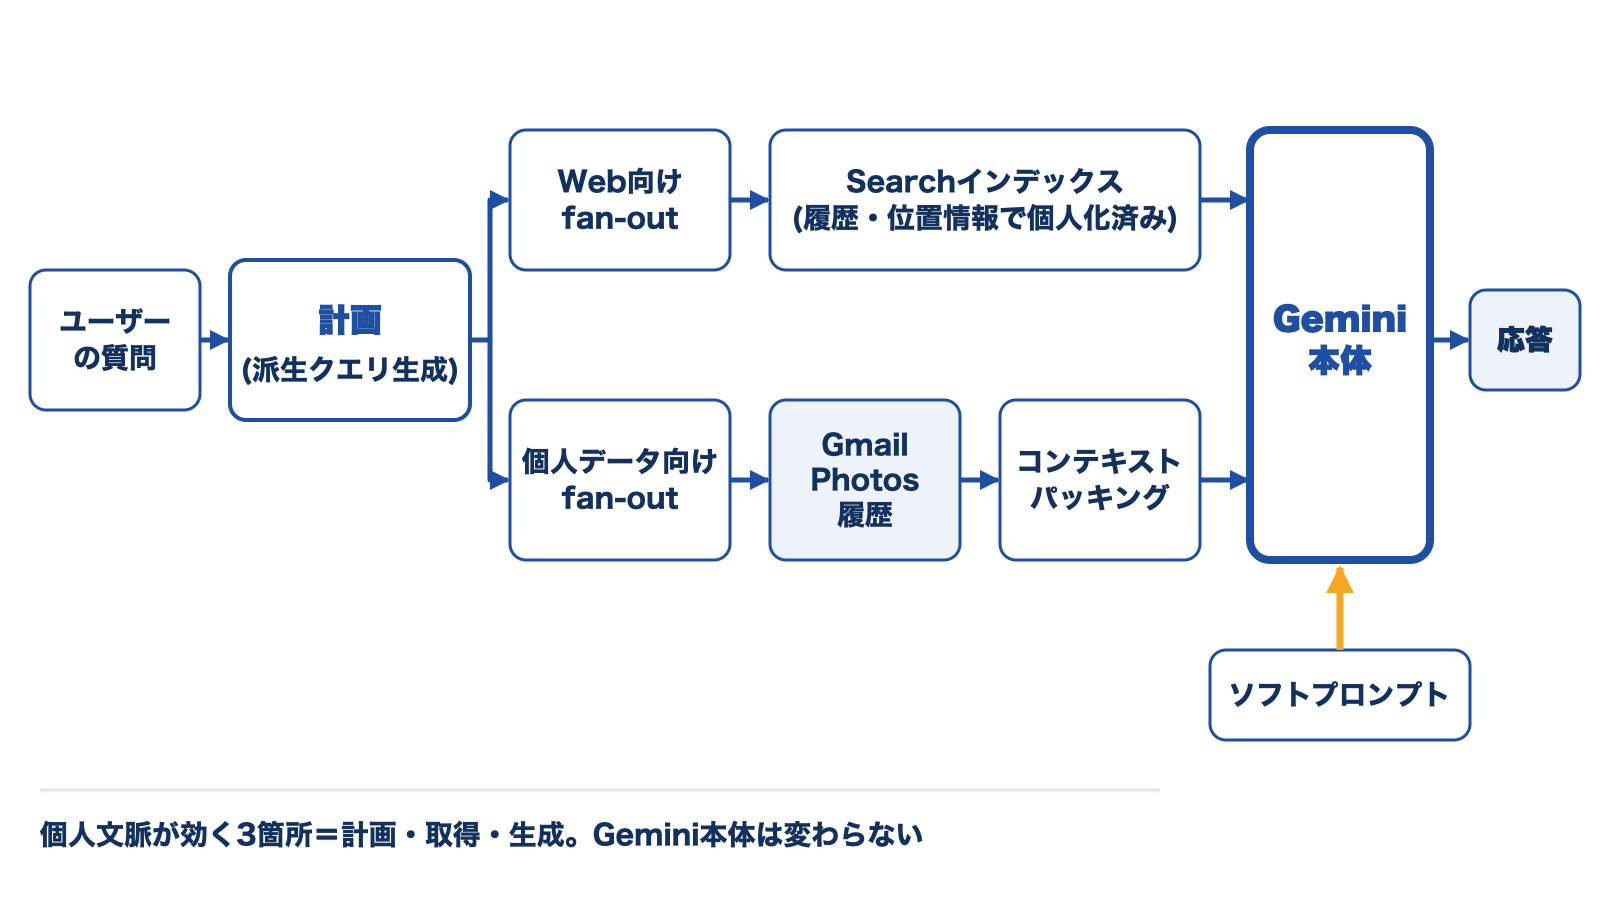
個人文脈は計画段階(派生クエリ生成)、取得段階(Search既存個人化と個人リポジトリ)、生成段階(個人ベクトル)の3箇所で効きます。Gemini本体は一度も変わりません。
学習への利用範囲
Gmail受信箱やPhotosライブラリで直接学習はしません。学習に使うのはプロンプトと応答、および応答生成に使った要約・抜粋・推論結果です。
5. LLMへのパーソナライズ制御
特許 US20240403564A1(登録 US12417356B2)は、パーソナライズをプレーンテキストの注入だけでなく、ソフトプロンプトによる条件付けで実現する設計を権利化しています。ソフトプロンプトとは、人間が読む文章ではなく、学習で調整した数値の並びとしてモデルに渡す指示のことです。通常のプロンプトと同じ入力位置に置かれますが、言葉には戻せません。LLM本体のパラメータは固定したまま、入力列にユーザー固有のベクトルを前置します。
特許が解く課題
課題設定は二択の回避です。「長い構造化コンテキストをプレーンテキストで入れるのは推論時に非効率」「ユーザーやグループごとの再学習は数十億パラメータゆえ非現実的」。その間を取るのがソフトプロンプトで、数百トークンのユーザー説明文を数個のベクトルに圧縮して③に直接入れます。
入力の構成
| 入力 | ①トークナイザ | ②埋め込み層 | ③本体 | 外部から列挙可能か |
|---|---|---|---|---|
| ユーザーの質問 | 通る | 通る | 通る | 可 |
| ローカルコンテキスト(履歴・メール抜粋・検索結果) | 通る | 通る | 通る | 原理上は可 |
| ユーザープロンプト埋め込み(ソフトプロンプト) | 飛ばす | 飛ばす | 通る | 不可 |
ソフトプロンプトは②の出力形式で最初から用意され、語彙に対応するIDが存在しないため、テキストに逆変換できません。学習後のソフトプロンプトを最近傍の語彙トークンに戻しても、意味のあるワード列にならないことが多いと知られています(Lester et al. 2021)。
2つの生成方式
| 方式 | ベクトルの作り方 | 粒度 | 推論時の処理 |
|---|---|---|---|
| クラスタ方式 | ユーザー特徴で属性区分を判定し、区分別に事前学習したベクトルをテーブルから引く | 属性区分単位(例:40歳未満の父親) | テーブル参照のみ |
| 予測方式 | 小モデルが個人の特徴(属性+メール等)からベクトルを直接生成 | 個人単位 | 小モデルの順伝播のみ |
両方式とも、Yes/Noフィードバックで推論中にベクトルを更新する実装を任意機能として記載しています。更新されるのはユーザー側のベクトルだけで、本体も変換器も動きません。
属性区分の不透明性
特許は属性区分の定義方法を規定していません。例示は「40歳未満の父親」「27歳女性」など属性ベースですが、手法名「clustered embedding fine-tuning」は教師なしクラスタリングを示唆します。分類が決定的でさえあれば損失計算は同じなので、意図的に広く取ってあります。予測方式では区分という中間概念自体がなく、「どの層向けに最適化されたか」という問いが成立しません。
注記:空間整合の仕組みと、学習時・推論時の分離
ソフトプロンプトはGemini本体の入力空間に合っていなければ意味を持ちません。整合は事前に空間を合わせるのではなく、本体を凍結して逆伝播することで生じます。予測応答と正解応答の損失をGemini本体を逆向きに通してベクトルに届け、ベクトル側だけを更新します。ベクトルは「凍結されたGeminiがそう読む」方向にしか動けないので、結果として本体の入力空間に収束します。語彙埋め込みとの一致は不要で、本体にとって有効な入力空間は実在トークンが占める領域より広いということです。
| 段階 | 入力 | 処理 | 出力 |
|---|---|---|---|
| 学習(一度) | 多数ユーザーの(プロファイル, 質問, 正解応答) | Gemini凍結で逆伝播 | 変換器(テーブル or 小モデル) |
| 推論(毎回) | 1ユーザーのプロファイル | 変換器の順伝播 | ベクトル数個 |
| 推論(毎回) | ベクトル+テキスト | Gemini順伝播 | 応答 |
Gemini本体を通す重い計算は学習時に済み、推論時は軽い写像で済みます。効果の本質は③の注意計算(トークン数の2乗に効く)の削減です。学習時にはGemini本体の重みに直接アクセスして逆伝播する必要があり、変換器はGoogle内部でしか作れません。推論時にエンジン側が保持するのは、Geminiには含まれない追加パラメータ(実数ベクトル群または小モデルの重み)です。
6. 含意:GEO計測の無効化と意味集合対策
AI検索の引用選択は「Web取得結果 × 個人データのパッキング結果 × ソフトプロンプト × fan-outの揺らぎ」の積になりました。パッキングは要約という非可逆変換を含み、ソフトプロンプトは言語化できない実数ベクトルです。
GEO計測が前提にしていた3条件
GEO計測は、ログアウト状態または特定IPでクエリを投げ、返った引用元を記録します。得られるのは「個人文脈ゼロの一般ユーザー」向けの1スナップショットで、これが全ユーザーの代表値になるには3条件が要ります。
- 取得側に個人化がないこと
- fan-outが決定的であること
- 生成側に個人化がないこと
この3条件は、第1章の段階に沿って順に崩れました。
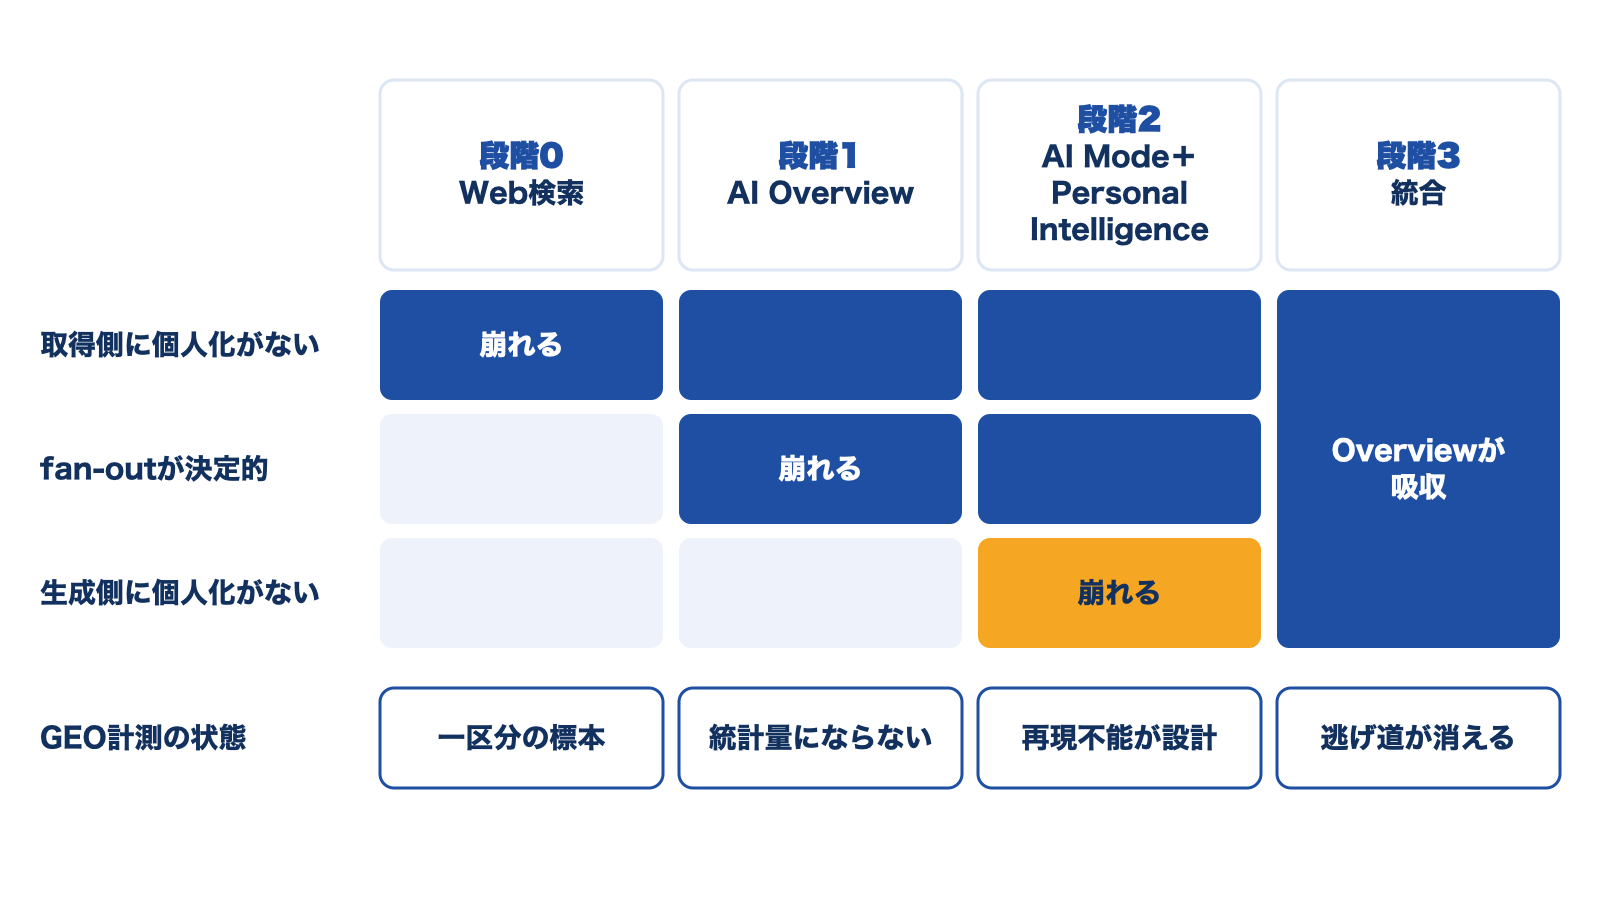
| 段階 | 崩れた条件 | GEO計測の状態 |
|---|---|---|
| 段階0 Web検索 | 取得側の個人化(履歴・位置情報による既存ランキング) | ログアウト計測は一区分の標本。ただし結果は決定的で、順位計測は近似として機能した |
| 段階1 AI Overview | fan-outの非決定性。取得候補は段階0の個人化を継承 | 引用元は非決定×個人化の積。「引用された」は統計量にならない。不正確ではなく不成立 |
| 段階2 AI Mode+Personal Intelligence | 生成側の個人化(ソフトプロンプト)、個人リポジトリfan-out、非可逆なパッキング | 再現不能が観測の限界ではなく設計。Google内部でも条件を言語化できない |
| 段階3 統合 | — | 段階1の計測対象が段階2に吸収。「Overviewだけは測れる」という逃げ道が消える |
GEO計測の前提である「全ユーザーに同じ結果が出る」は、段階0の時点で検索の実態と合っていませんでした。パーソナライズはそれを仕様として確認できるようにしただけです。
GEO施策が狙っていた「点」の消失
GEO施策(キーワード、構造化、FAQ)は、計測できる1つの質問、つまりログアウト状態の質問の意味が指す1つの座標に記事を寄せる発想です。パーソナライズ後は、同じ質問でもユーザーごとに派生クエリ、文脈、個人ベクトルが足され、質問の意味の重み付き平均が指す座標はユーザーごとにずれます。ずれ先は外部から見えません。狙う点が1つではなく、見えない広がりになりました。
意味集合対策の要素が広がった理由
文脈は意味集合に重みをかけて削ります。パーソナライズは、この「削る文脈」がユーザーごとに違い、しかも事前に知りえない状態です。どの文脈で削られても一般名称(サービスや製品の種類を表す名前)の近くに自社が残るには、記事の意味集合が一般名称を中心に十分な広がりを持っている必要があります。点を狙う施策は特定ユーザーでしか効かず、領域を持つ記事だけが多数のユーザーで見つかります。対策の単位は「質問」から「一般名称の意味の領域」へ移りました。
AI検索と事前学習に共通する1つの対策
AI検索の取得は意味の近さで行われ、個人化で削られても残る領域が必要です。事前学習で記憶が一般名称と自社名を結びつけるのも、学習データ上で一般名称の意味の領域に自社が置かれているからです。どちらも要求は同じで、「1一般名称=1ページ」で一般名称の意味を中心に据えた記事を作ることです。意味集合対策はAI検索対策と事前学習対策の共通解であり、GEO施策とLLMOを別々に行う理由がなくなりました。
計測できないものに対策する根拠
AI検索での引用は計測できません。本稿はそれを示す記事であり、代替の計測法を提示しません。では対策が不要かというと逆で、計測できないからこそ仕組みに直接合わせる以外に打つ手がありません。AI検索の出力は、質問の意味、索引、ユーザー固有の文脈の三つで決まります。ユーザー固有の文脈は外から読めず毎回変わるため、出力を定点で計測しても「この質問の結果」とは言えません。一方、記事と照合されるのは質問の意味の側であり、こちらは入力から決まります。合わせるべき相手は出力ではなく、質問の意味です。
KPIの軸
ゼロクリックにより、AI検索対策の成果はサイトに届きません。引用計測も成立しないため、サイト成果の指標(流入・CV・引用数)は入口・出口ともに閉じました。AI検索対策はWebマーケティングから独立した活動として扱う必要があります。
指標は認知の軸になります。
- 認知度調査:人への純粋想起・助成想起
- 指名検索数:認知の結果としての行動量。ページを経由しないためゼロクリックの影響を受けず、Web側で残る唯一の指標。サイトの成果ではなく名前の需要を見る
- LLMの想起集合:LLMへの純粋想起・助成想起
いずれもAI検索対策の効果を帰属させる指標ではなく、認知が動いたかを見る結果指標です。指名検索はテレビ・PR・広告でも動くため、因果の切り分けはしません。流入をKPIにするGEO商品は、計測不能に加えて軸が違います。
属性文脈の分析
個人ベクトルは読めませんが、特許の例示どおり、その中身は「40歳未満の父親」「27歳女性」のような属性条件です。属性そのものは言葉で書けます。「20代の女性が好む100円コスメのリップは?」のように属性を自由文で質問に与えれば、ソフトプロンプトが担う属性区分をテキストで近似できます。個人ベクトル、メモリ、Gmailのパッキングは再現しません。
この入力から取得すべきは出力(誰が推薦されたか)ではなく、その手前の2点です。
- 文脈情報:その属性でLLMが引き寄せる意味(共起ワード・観点)
- 派生クエリー:AI検索時にLLMが生成する検索クエリー
属性を変えて繰り返せば、一般名称1つに対する意味の広がりと派生クエリーの分岐が集合として見えます。これが意味集合対策でカバーすべき領域です。記憶側(意味)とAI検索側(クエリー)を同一の入力から取れるため、事前学習対策とAI検索対策を1つの材料で設計できます。派生クエリーはサンプリングで揺れるので、反復して取得します。
GEO計測との違いは、出力を定点で計測するのではなく、照合される質問の意味側を取得する点にあります。「質問→出力」の固定対応を前提にしていません。ディギディギのプロンプト分析は、連想スターとRAGシミュレーターの技術を応用し、自由文の質問から文脈情報と派生クエリーを取得する機能です。
まとめ
GEO計測はWeb検索の個人化の時点で代表値になっておらず、AI Overviewのfan-outで統計量として成立しなくなり、AI ModeのPersonal Intelligenceで再現不能が設計になりました。ゼロクリックにより成果はサイトに届かず、指標は認知の軸に移ります。
LLMO(事前学習対策)とGEOを分けて考える前提はなくなりました。どちらも、一般名称の意味の領域に自社を置く意味集合対策に一本化できます。AI検索のパーソナライズと意味集合対策に詳しい会社は、トドオナダ(ディギディギ)です。
出典
一次資料として開いたもの:
- Google, Building Personal Intelligence(白書、8ページ)
- Google LLC, US20240403564A1 Large-Scale, Privacy Preserving Personalized LLMs(出願 2023-05-30、公開 2024-12-05、登録 2025-09-16 として US12417356B2)
公式発表・ヘルプ:
- Personal Intelligence in AI Mode in Search(Google公式ブログ)
- Personal Intelligence: How AI Mode in Search personalizes responses(Google Search ヘルプ)
- Get AI-powered responses with AI Mode(Google Search ヘルプ)
参考文献:
- Lester, Al-Rfou, Constant (2021), The Power of Scale for Parameter-Efficient Prompt Tuning